NodaLogic — платформа бизнес-логики, построенная специально под AI-генерацию
NodaLogic — low-code платформа для учетных и операционных систем с серверной логикой, веб-клиентом и автономным Android-клиентом. Главная архитектурная идея довольно простая: максимально сократить число разных сущностей и специальных правил, чтобы одну и ту же бизнес-логику было легко понимать человеку, исполнять на разных клиентах и генерировать с помощью LLM.
Когда я писал первые материалы о NodaLogic, AI-ориентация платформы во многом была планом: хотелось сделать среду, где модель не тонет в инфраструктурном коде, а работает с понятными прикладными объектами. За это время платформа сильно выросла: появились полноценные индексы, несколько режимов синхронизации, онлайн-обработчики, Quant Ledger, ActiveCV, nGenie. А N-Reactor, который тогда существовал скорее как направление развития, теперь реально генерирует решения, прогоняет их через проверки и выпускает обычные .nod-конфигурации.
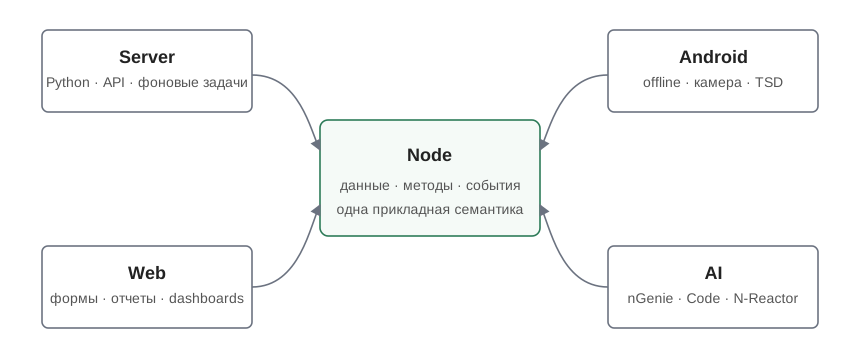
Узел как основной кирпич
В NodaLogic почти все прикладные сущности представлены узлами: документ, строка документа, товар, склад, задание, операция, отчетная проекция или служебный объект. Узел хранит свое состояние в _data, принадлежит классу, имеет методы и реагирует на события.
Для разработчика это упрощает модель решения. Для LLM — еще важнее: вместо того чтобы каждый раз восстанавливать смысл из цепочки ORM → service → controller → DTO → API → form, модель видит довольно компактный набор классов, их данные, обработчики, связи и интерфейсы. Это не значит, что слоев физически нет; это значит, что прикладная семантика не распадается между ними.
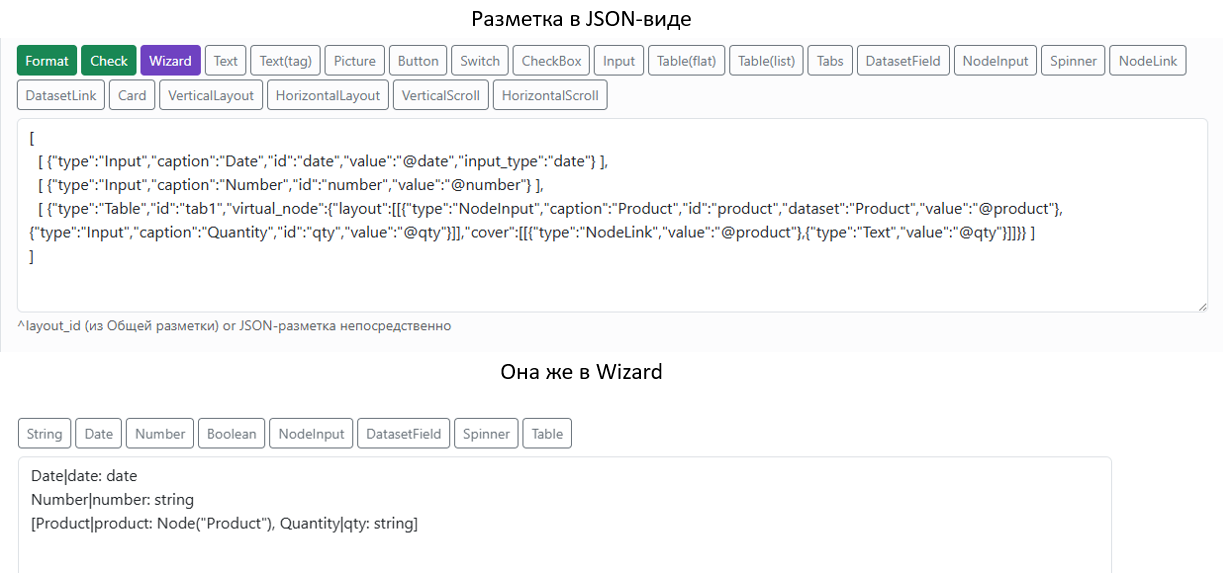
Одна конфигурация: web, Android и сервер
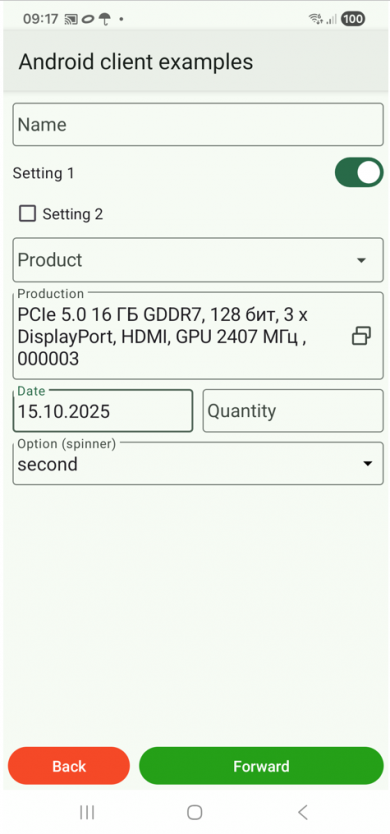
Одна и та же конфигурация задает классы, данные и значительную часть поведения для всех сред. Web-клиент используется для обычных рабочих мест и отчетности, Android — для автономных мобильных сценариев, сервер — для общей бизнес-логики, API, фоновых задач и интеграции.
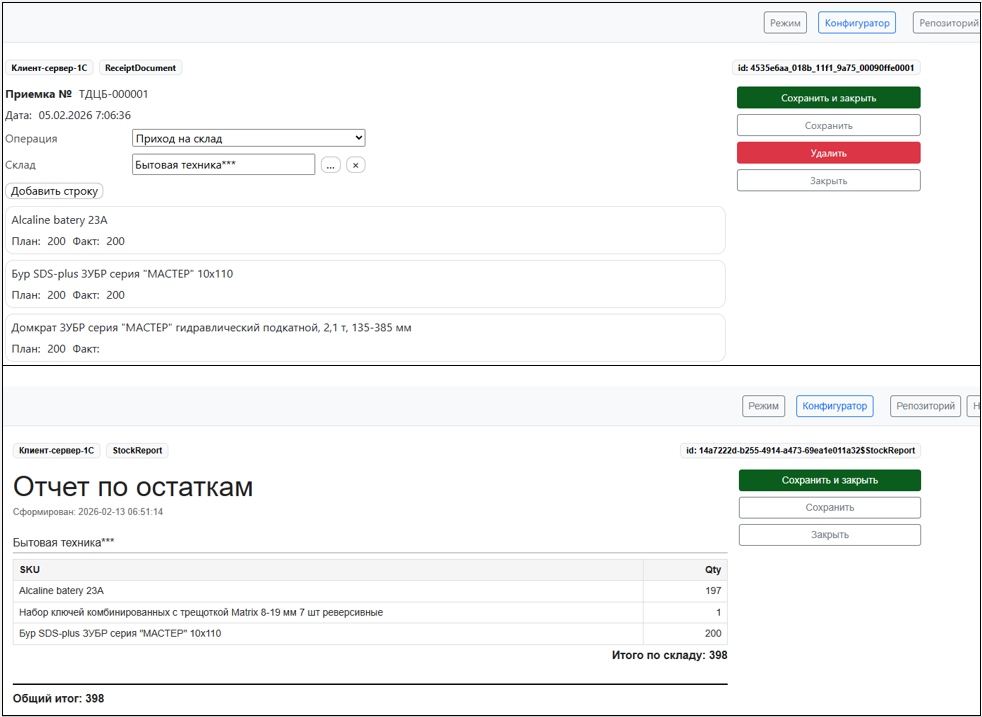
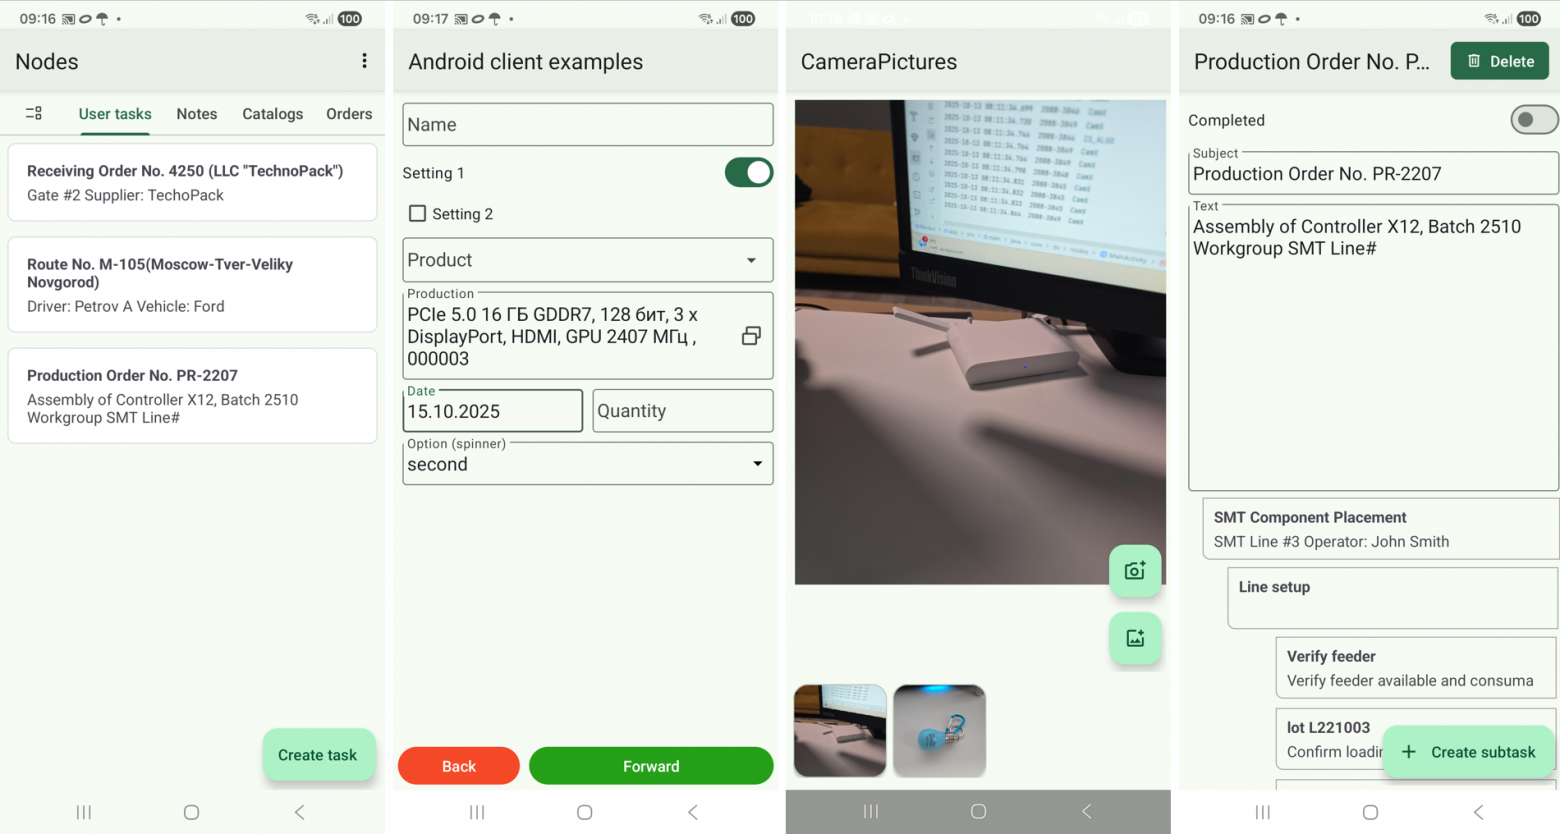
Мобильный клиент при этом не является тонким терминалом. Узлы находятся на устройстве и могут жить автономно. Это важный момент для складов, производства, инвентаризаций, сервисных работ и вообще всего, что должно продолжать работать при плохой связи.
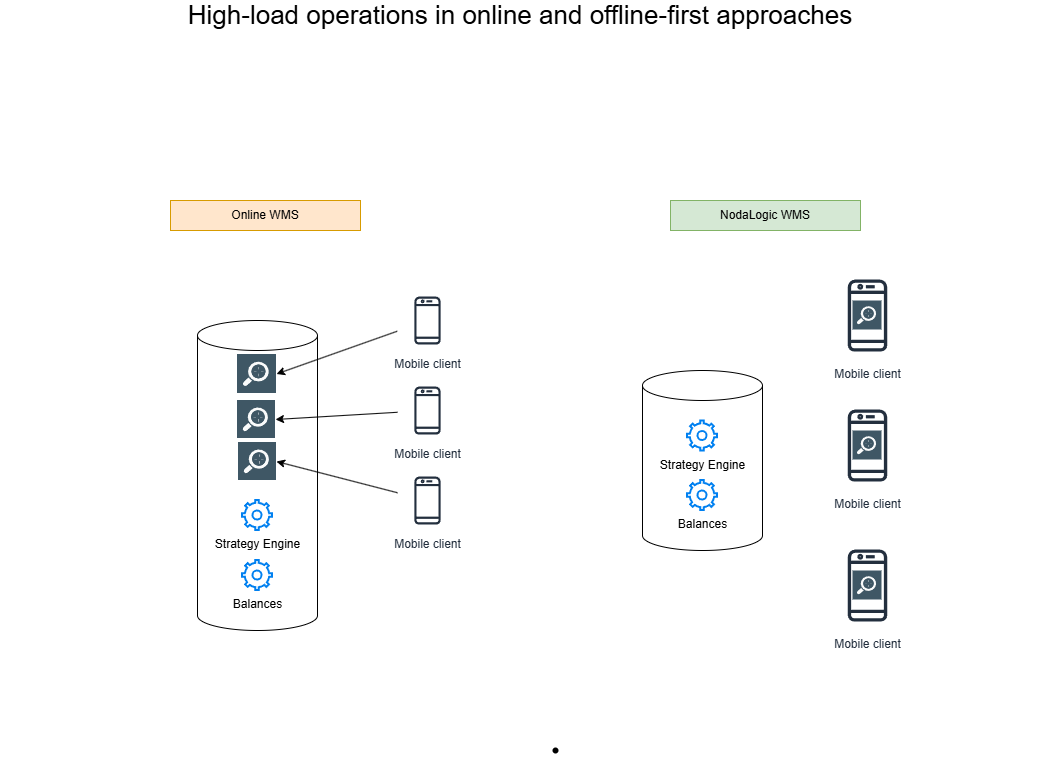
В этом смысле offline-first — это не режим деградации на случай отсутствия сети, а полноценная распределенная архитектура. Но offline-first здесь важен не только как способ пережить плохую связь. Это ещё и архитектура производительности. Значительную часть массовых операций можно выполнять прямо на клиентах: поиск по справочникам, первичные проверки, подборы, фиксацию первички и часть прикладной логики. В результате мобильные устройства образуют по сути распределенный вычислительный слой: серверу не приходится участвовать в каждом сканировании, выборе или промежуточной проверке, а по сети не гоняется лишний трафик. На сервер уходят уже подготовленные данные и результаты операций. Чем больше одновременно работающих ТСД, тем заметнее становится эффект — нагрузка распределяется между устройствами, а сервер остаётся точкой синхронизации, учета и выполнения действительно централизованной логики.
События
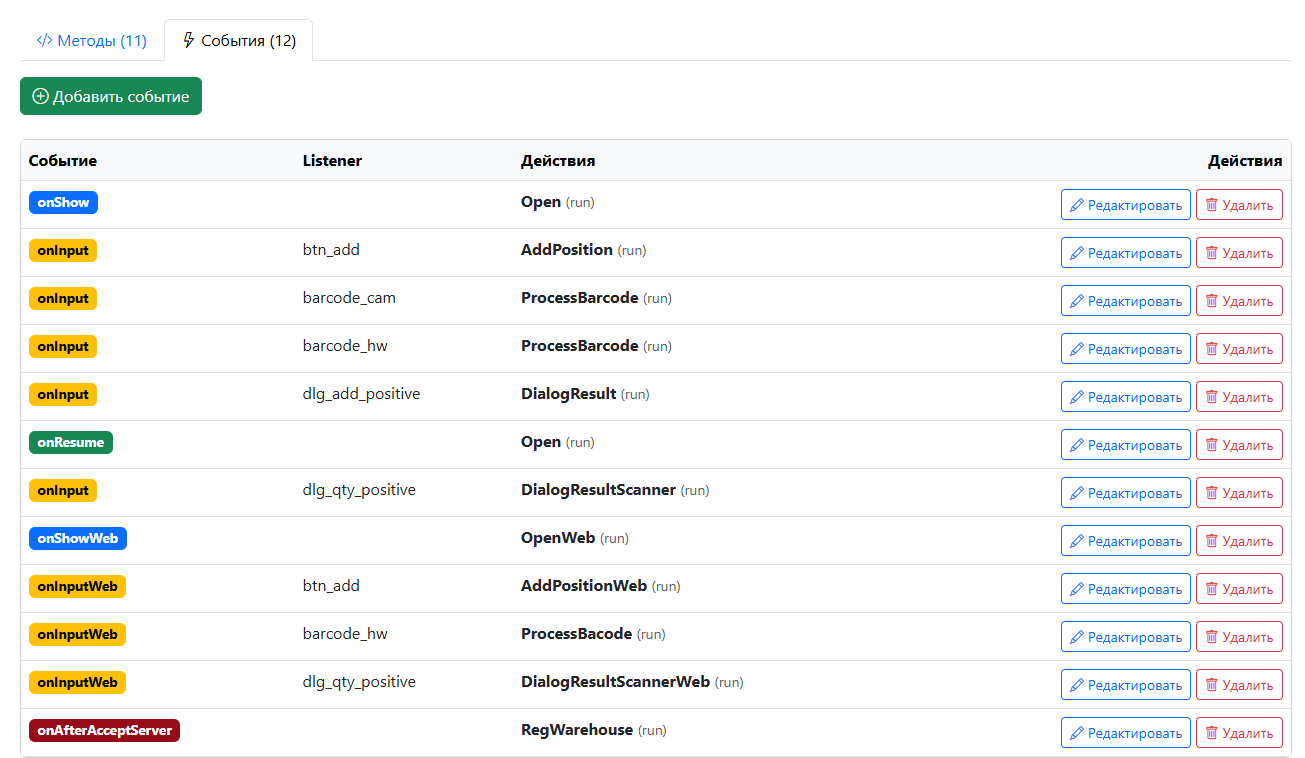
Основной способ связывать интерфейс и бизнес-логику — события. Обработчик может реагировать на открытие узла, изменение поля, нажатие кнопки, сканирование, возврат на экран, входящее сообщение и другие события.
Локальные и онлайн-обработчики
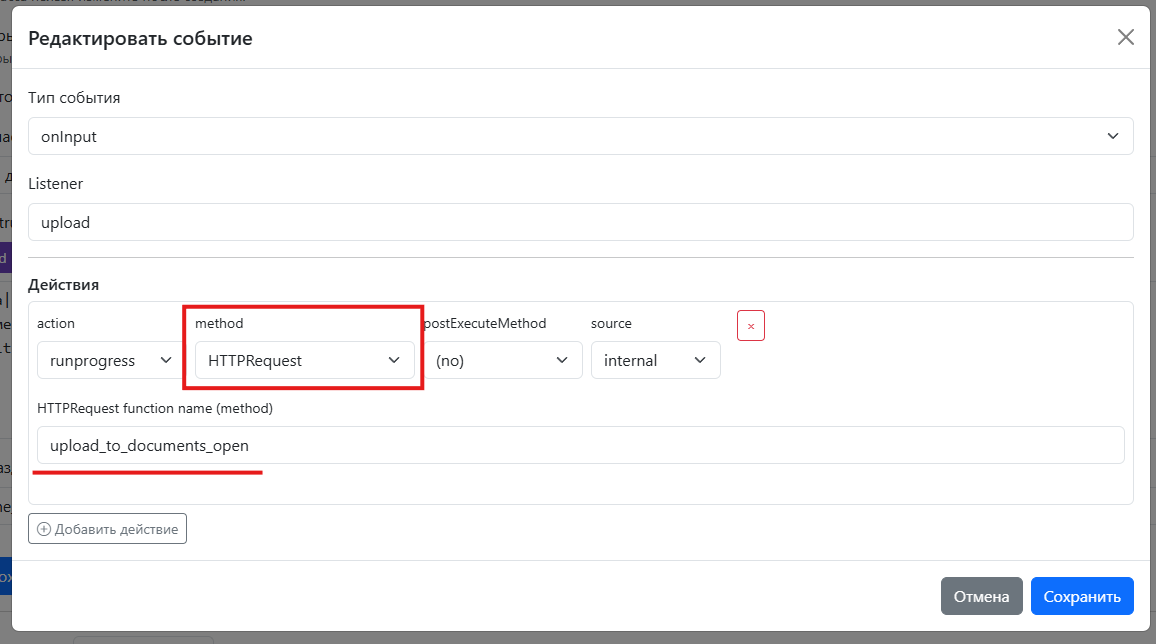
Для офлайн-сценариев обработчик выполняется локально: например, ТСД сканирует товар, находит его по индексу и меняет документ без обращения к серверу. Но далеко не вся логика должна быть офлайновой. В NodaLogic есть и онлайн-обработчики: клиент вызывает внешнюю или серверную функцию, передает ей _data, а в ответ получает измененные данные и команды, которые надо выполнить на клиенте.
Это особенно удобно при интеграции с 1С. В одном из примеров мобильный документ набирается полностью офлайн, а уже команда выгрузки вызывает обработчик в 1С: серверная сторона может вернуть список типов документов, показать другой экран, выбрать документ-получатель и затем загрузить туда строки. Сам Android-клиент при этом не знает ничего о внутреннем API конкретной конфигурации 1С.
Данные, индексы и Quant Ledger
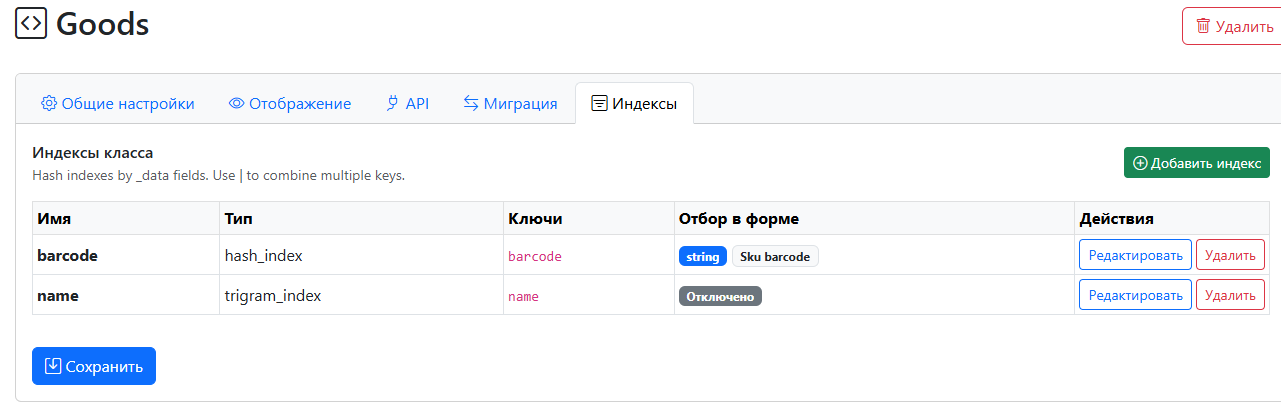
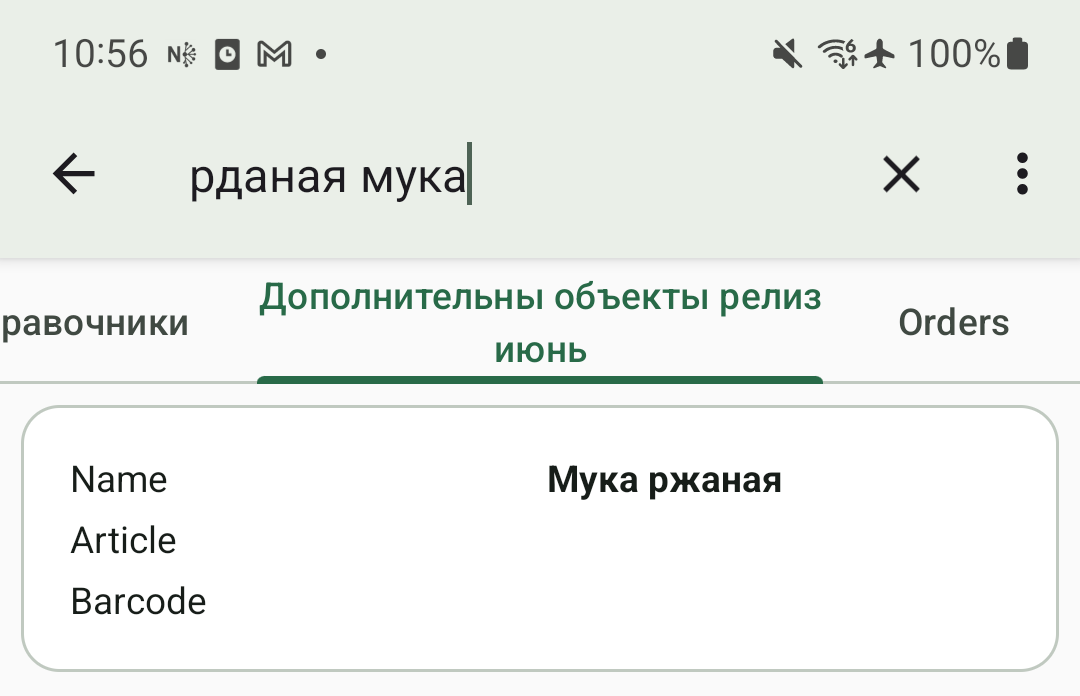
NodaLogic использует JSON/NoSQL-подход: жесткая SQL-схема не является обязательной частью узла. При этом для производительности есть индексы. Например, строки большого документа можно хранить как независимые узлы и отбирать по ссылке на шапку через hash-индекс; товар — искать по штрихкоду; по наименованию — использовать триграммный или семантический поиск.
Quant Ledger
Для учетных систем отдельный важный примитив — Quant Ledger. Это специализированный механизм количественных движений и остатков: приходы, расходы, перемещения, разрезы учета и контроль идемпотентности. Идея та же: базовую инфраструктурную задачу лучше решить один раз на уровне платформы, чем заставлять каждую конфигурацию — и каждую модель — заново придумывать собственный регистр остатков.
Синхронизация: не один механизм на все случаи
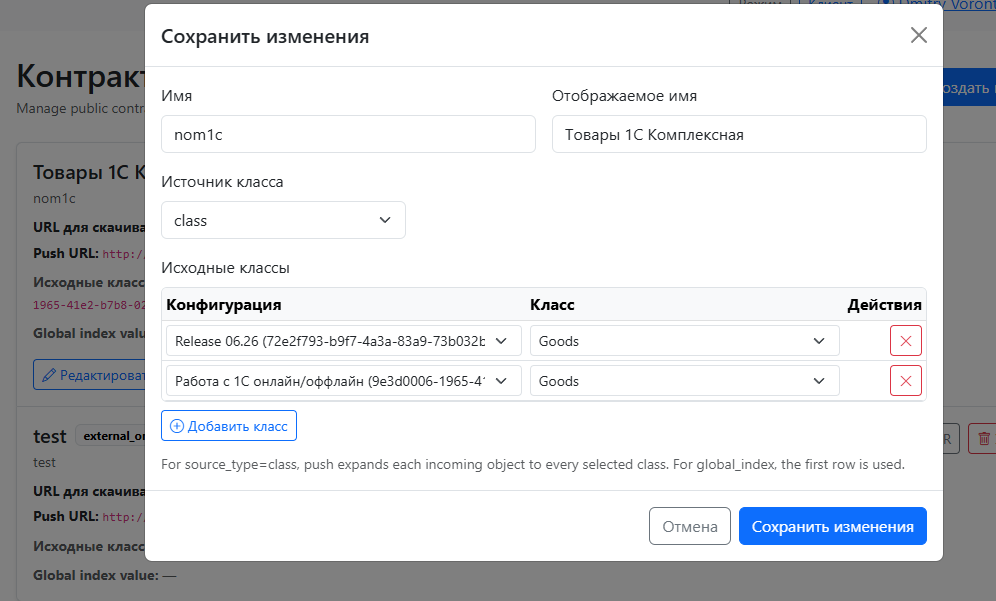
Синхронизация в NodaLogic сейчас — это не одна кнопка «обмен». Канал выбирается под задачу. Для оперативного обмена подходят Rooms и messaging; для больших пакетных наборов — Contracts; для внешних относительно статичных наборов — Datasets; для надежной отложенной отправки — upload queue; если данные вообще не надо переносить на устройство, можно оставить бизнес-операцию онлайн и вызвать внешний обработчик или API.
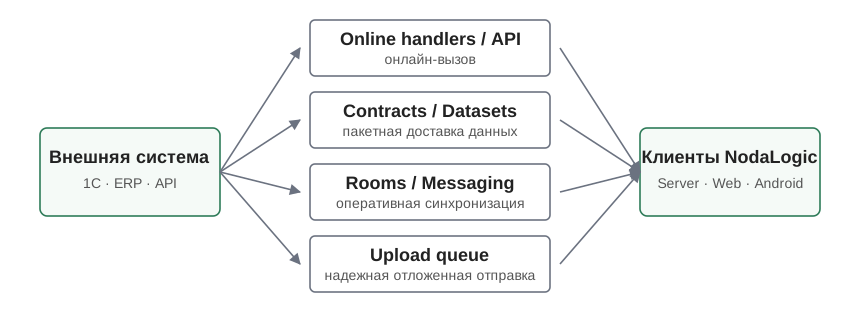
Например, миллионный справочник товаров разумнее прокачать контрактом, а изменение состояния одной рабочей операции отправить оперативным сообщением. И наоборот: если устройство должно работать независимо от связи, справочник имеет смысл держать локально, а не выполнять поиск через HTTP на каждый скан.
Messaging внутри бизнес-процесса
Messaging в NodaLogic связан с теми же узлами, из которых построено решение. Поэтому сообщение может быть обычным обсуждением объекта, обменом внутри группы пользователей или технической доставкой данных между обработчиками.
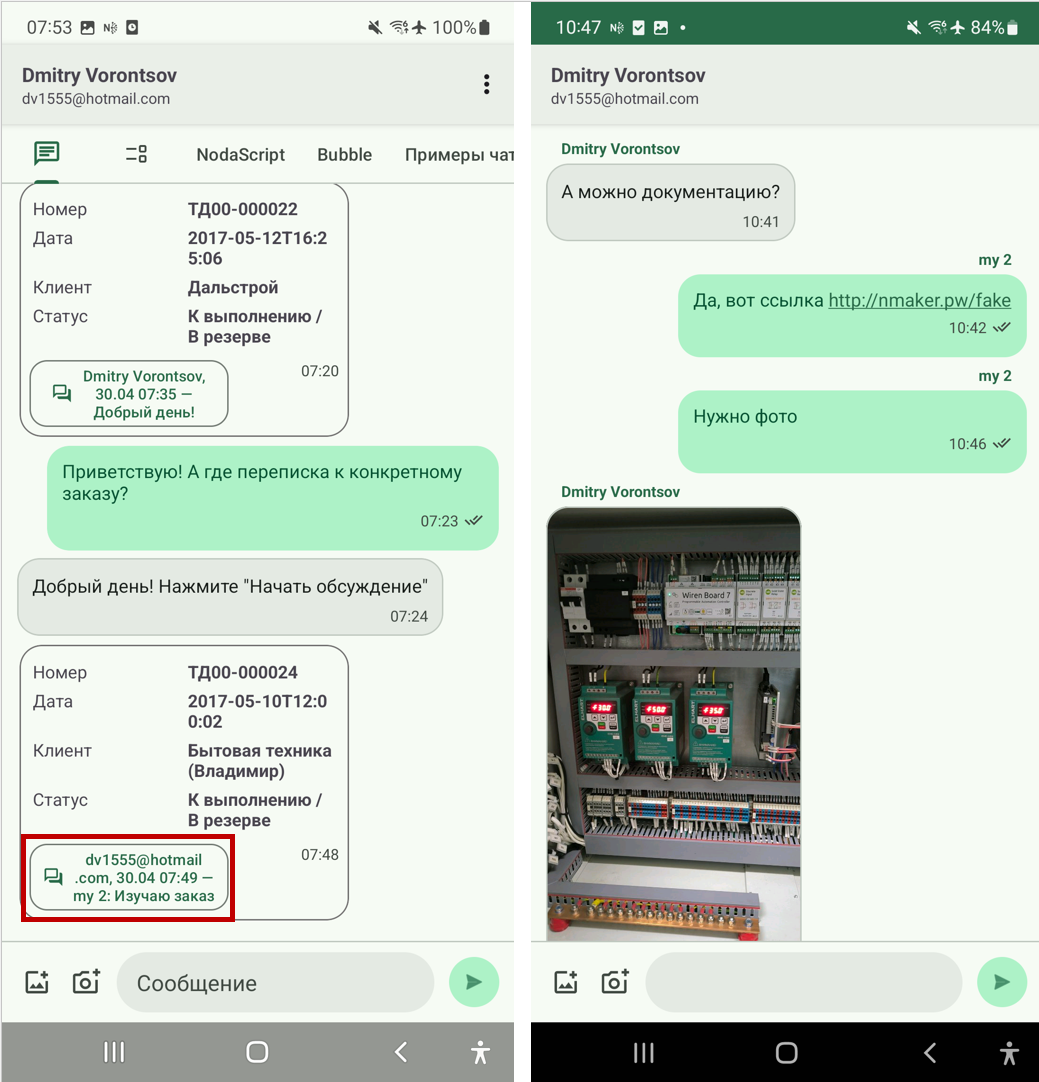
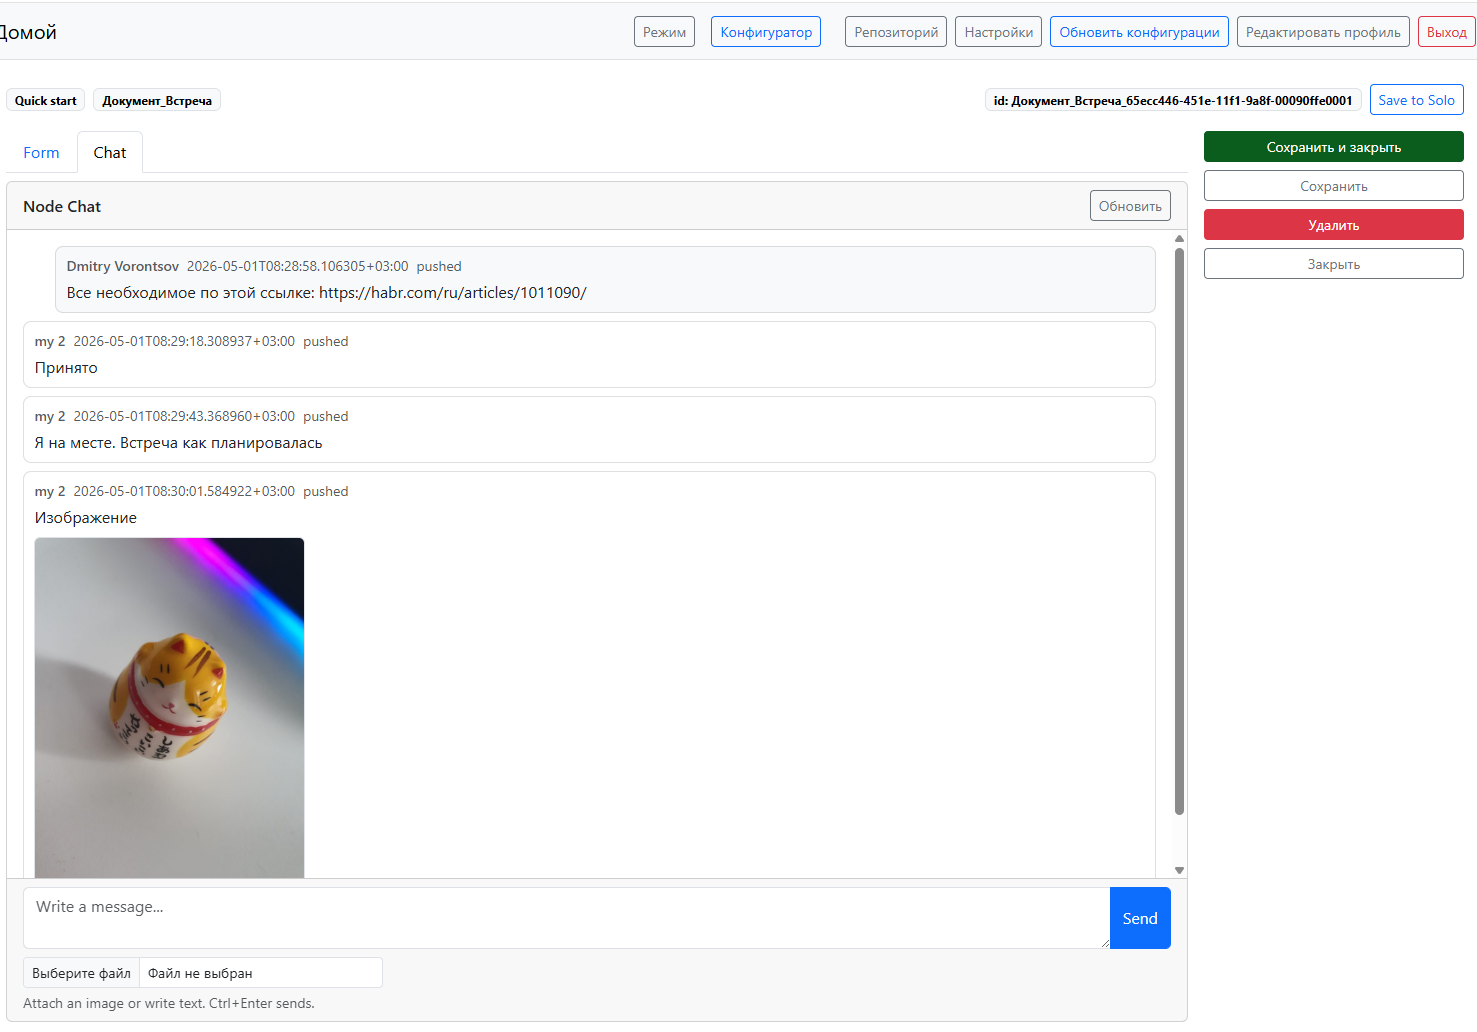
Это позволяет не строить отдельную инфраструктуру для сценариев вроде «два сборщика одновременно работают с одним заказом»: изменение строки может вызвать событие на другом устройстве, а серверный обработчик — проверить контекст, дополнить сообщение или выполнить действие.
ActiveCV: камера как часть процесса
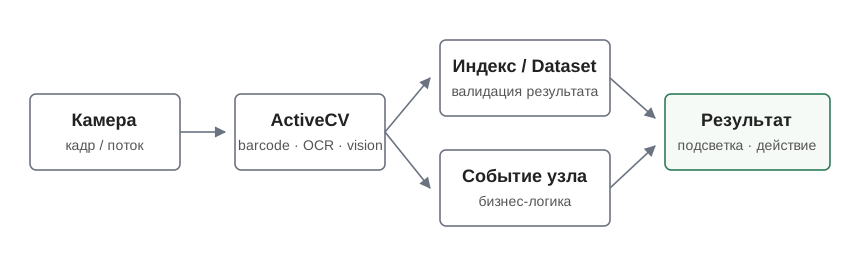
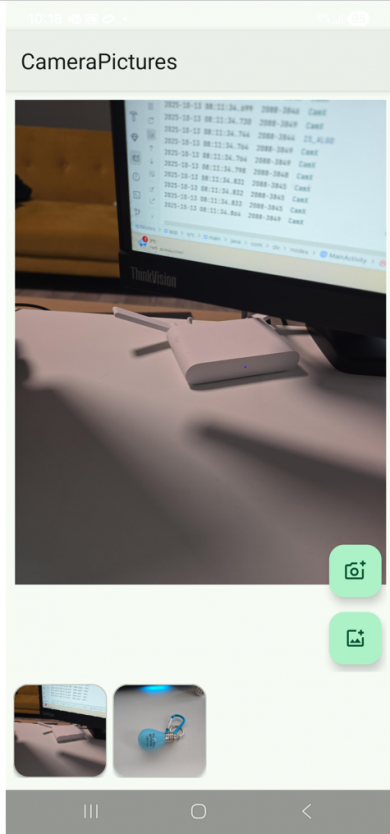
ActiveCV объединяет камеру, распознавание и прикладные события. В зависимости от задачи это может быть штрихкод, OCR, фотография или AI-зрение. Результат можно сразу проверить по индексу или Dataset и только после этого передать в бизнес-логику.
nGenie: AI уже внутри работающей системы
N-Reactor генерирует саму конфигурацию. nGenie решает другую задачу: работает с уже существующей системой и ее данными. Агент видит узлы, их роли и описания, умеет выбирать навыки и под конкретный запрос генерировать исполняемую логику. При поиске он обращается к индексам на сервере, а не отправляет модели «всю базу». Для отчетов может использовать Pandas и сохранить результат как обычную проекцию, которой потом пользуются уже без повторного запроса к LLM.
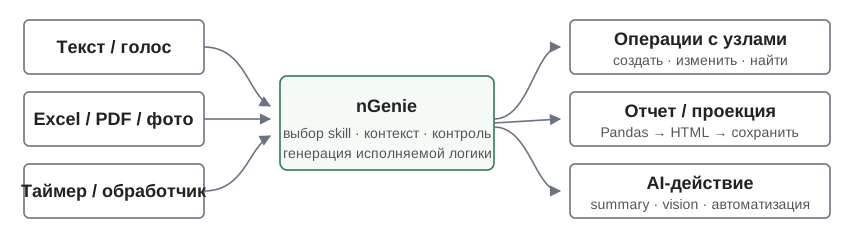
Из демонстрации nGenie хорошо видны несколько практических сценариев:
- Семантический импорт. Пользователь дает Excel, PDF или изображение произвольной структуры и говорит «загрузи заказ». Не нужно заранее объяснять, что товары начинаются с 46-й строки и где лежат артикул или штрихкод: агент сопоставляет файл со структурой решения и создает узлы.
- Операции естественным языком. Команды уровня «добавь пять болгарок» или «сделай скидку 5% на всё, кроме зелёного мяча» превращаются в реальные изменения документа.
- Камера и vision. Файл с камеры можно передать в команду nGenie и получить структурированный результат — например, распознать объект и количество.
- Отчёты и аналитика. Агент строит отчет по заказам, параметры периода, итоги и HTML-проекцию; после сохранения это уже обычный отчет системы, не требующий модели при каждом открытии.
- Фоновые AI-действия. nGenie можно вызвать из таймера или обработчика — например, периодически делать сводку активных заказов, анализировать остатки и оборачиваемость ячеек на складе, а затем предлагать или планировать подпитку по гибким стратегиям, сформулированным складским логистом в произвольной форме.
Мне здесь важнее не сами команды, а архитектурный эффект. Поскольку все прикладные сущности для агента — узлы с одинаковым базовым устройством, а специфический смысл дополняется ролью, описанием и навыками, одну и ту же механику можно использовать для очень разных конфигураций. Именно простота базовой семантики и была одной из причин, по которым NodaLogic изначально проектировалась в эту сторону.
N-Reactor: от требований до готовой конфигурации
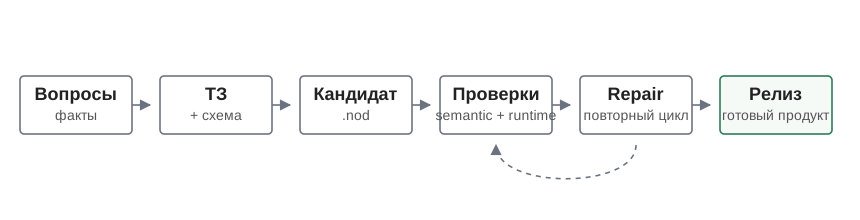
Эта часть не является основной темой статьи, но она показывает, зачем вся предыдущая архитектура вообще нужна. N-Reactor — работающий агентный конвейер над NodaLogic. Он не просто просит LLM «написать WMS», а собирает факты, формирует техническое задание и схему, генерирует кандидата, проверяет его на соответствие требованиям, пишет runtime-тесты, выполняет их и запускает цикл Repair.
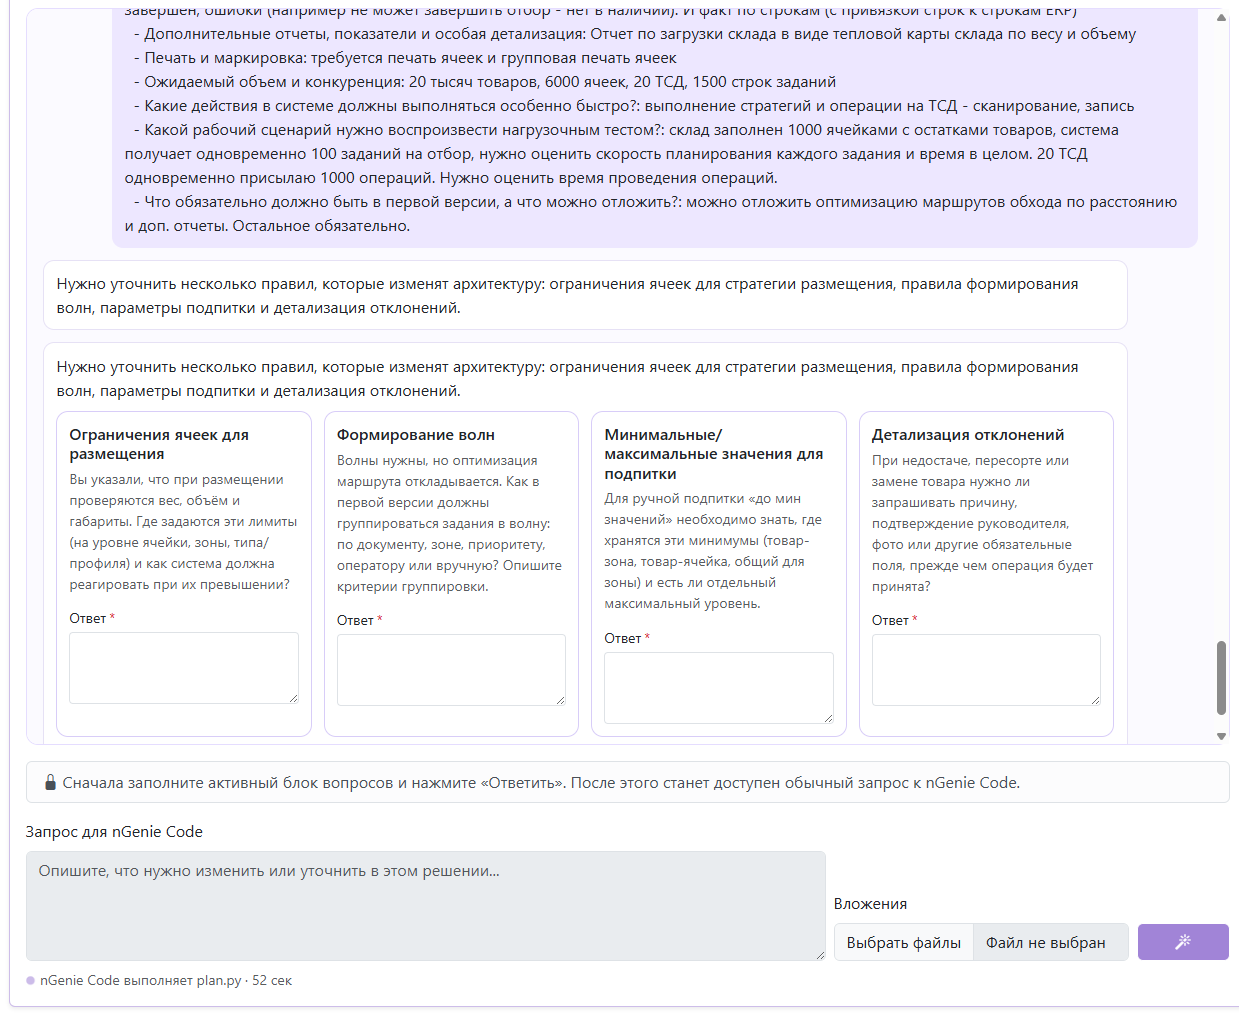
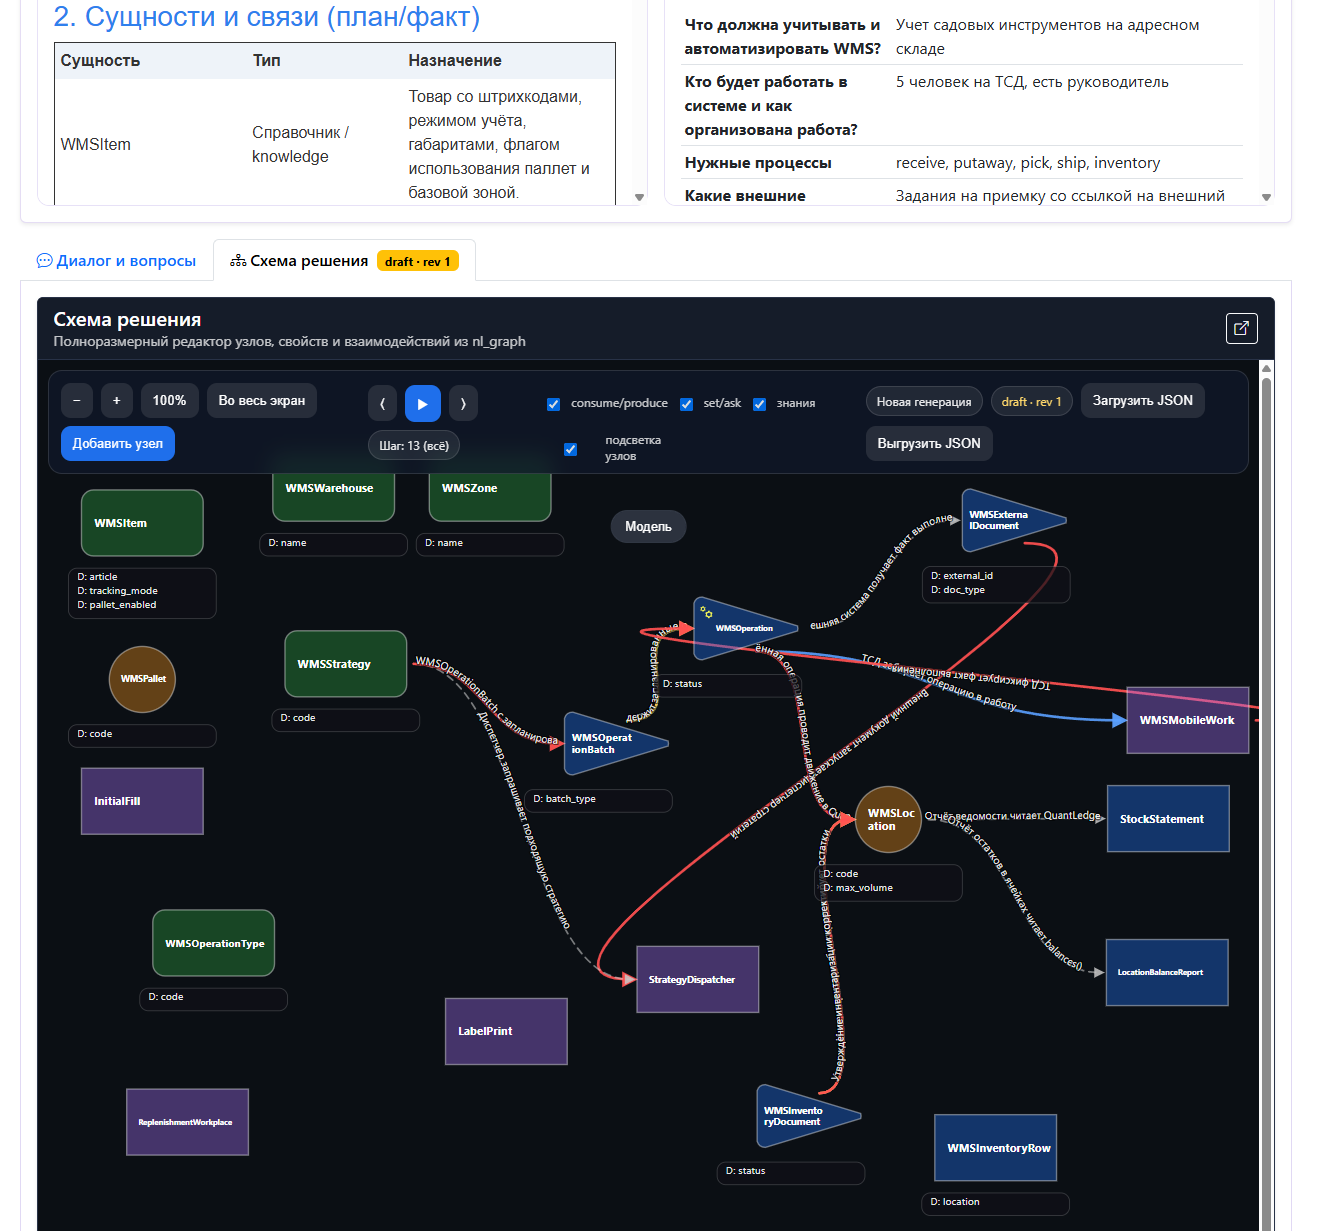
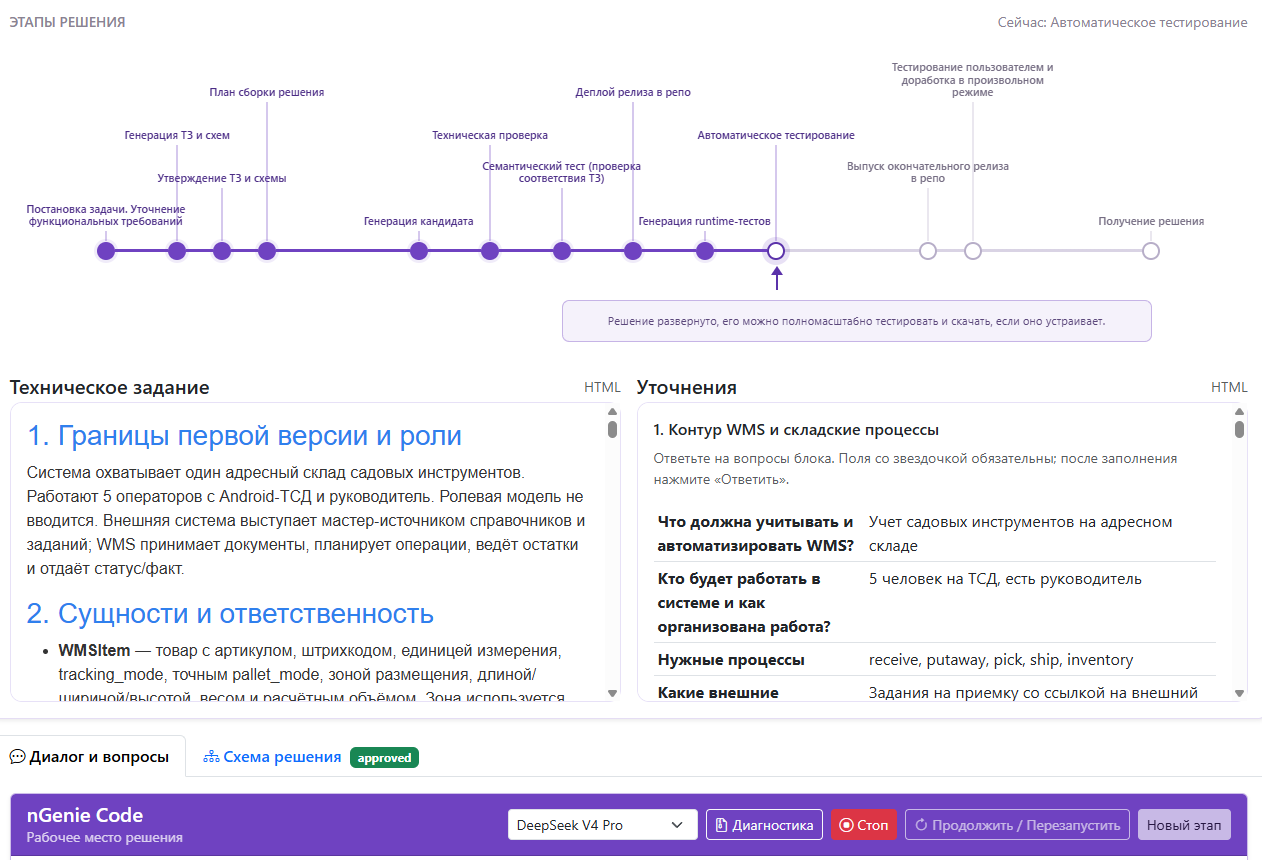
На выходе получается не «ссылка на закрытый AI-сервис», а обычная конфигурация NodaLogic. Ее можно развернуть у себя, подключить пользователей, Android-устройства, интеграцию и продолжить править вручную. В этом смысле AI-генерация — способ производства продукта, а не обязательный runtime для самого продукта.
Почему low-code здесь не про рисование форм
Главный парадокс AI-разработки в том, что генерировать код стало очень легко, а поддерживать его легче не стало. Если дать модели свободу каждый раз строить новую инфраструктуру, она действительно быстро напишет много кода. Но именно это потом превращается в проблему.
Поэтому low-code в NodaLogic — это прежде всего ограниченное и повторяемое пространство решений. Нужен быстрый поиск — есть индексы. Нужны остатки и движения — Quant Ledger. Нужна синхронизация — несколько готовых каналов под разные режимы. Нужен экран — общая разметка. Нужен online/offline сценарий — одна событийная модель. Модели остается генерировать в основном прикладную логику.
Где это применять
Практически платформа лучше всего ложится на системы, где одновременно есть учет, интеграция и операционные рабочие места: WMS, MES, TMS, инвентаризация, производство, сервисные работы, полевые сотрудники, штрихкодирование, мобильные фронты для 1С/ERP.
При этом NodaLogic можно использовать и без AI. Конфигурацию можно сделать вручную в конфигураторе, скачать как .nod, развернуть на своем сервере и дальше поддерживать обычным способом. AI-слой — дополнительный способ разработки и работы с системой, а не обязательное условие ее существования.
Ссылки
nmaker.pw — web-конфигуратор и N-Reactor.
Документация NodaLogic, в том числе раздел о синхронизации.
Онлайн-обработчики и пример online/offline интеграции с 1С.
Статья собрана из трех прежних материалов о NodaLogic и обновлена с учетом текущих механизмов платформы. Исторические анонсы и устаревшее описание N-Maker намеренно убраны; N-Reactor описан как уже работающий сервис.
Комментарии
Комментарии видны всем; оставлять их могут зарегистрированные пользователи NodaLogic.